目次
- はじめに
- 1. InfiniBandとは
- 1-1. 高性能コンピューティング用ネットワーク
- 1-2. 低レイテンシ・高帯域幅
- 1-3. RDMA(Remote Direct Memory Access)とGPU間通信の高速化対応
- 1-4. データセンター標準技術
- 2. InfiniBandの歴史と種類
- 3. Ethernetとの違い
- 4. NVIDIA DOCA vs MLNX_OFED
- 5. NVIDIA DOCAインストール手順
- 5-1. DOCAパッケージダウンロードページ
- 5-2. DOCAパッケージダウンロード
- 5-3. パッケージインストール
- 5-4. DOCA Networkingインストール
- 5-5. 再起動
- 5-6. インストール後の確認
- 5-7. トラブルシューティング
- 6. よくある質問
- 7. まとめ
はじめに
大規模なAI学習や科学技術計算を行うHPC(高性能コンピューティング)の現場では、複数ノード間で大量のデータを交換するため、ノード間の高速で低遅延なネットワークがシステム全体の性能を左右する重要な要素です。NVIDIA® ConnectX®シリーズは、InfiniBandとEthernetに対応するネットワークアダプタ(SuperNICを含む)で、GPUクラスター間の通信を高速化するために広く使われています。本コラムでは、InfiniBandの基礎知識から始めて、ConnectXドライバーの最新インストール方法まで、実務で役立つ情報をまとめました。特に、従来のMLNX_OFEDからNVIDIA DOCA™への移行が進んでいる現在、DOCAを使ったインストール手順は情報が少ないため、実際の手順を詳しく解説します。
1. InfiniBandとは
1-1. 高性能コンピューティング用ネットワーク
InfiniBandは、スーパーコンピュータやHPCクラスターなど、計算性能を最優先する環境向けに設計されたネットワーク規格です。一般的なEthernetとは異なり、低レイテンシ(遅延)と高帯域幅に特化しています。1-2. 低レイテンシ・高帯域幅
InfiniBandでは、現行の主力世代であるNDRにおいてシングルリンクで400Gb/sの帯域幅と、1µs(マイクロ秒)未満の極めて低い遅延を実現しています。これは、大規模な並列計算において、ノード間の通信がボトルネックになることを防ぐために重要な特性です。さらに上位世代としてXDRがあり、800Gb/sの帯域幅まで拡張されています。1-3. RDMA(Remote Direct Memory Access)とGPU間通信の高速化
InfiniBandの大きな特徴の一つが、RDMA(Remote Direct Memory Access)という技術です。通常のネットワーク通信では、データがCPUを経由して転送されますが、RDMAではHCA(Host Channel Adapter)が制御するネットワークによりCPUを介さずにリモートメモリへ直接読み書きします。つまり、アプリケーションからはメモリを操作するように見える処理を内部ではネットワーク転送として実行することで、CPUの介在やデータコピーを減らして、低遅延・広帯域を実現しています。特にGPU間通信では、GPUDirect RDMAという技術と組み合わせることで、ホストメモリを経由せずにGPUメモリ間で直接データ転送が可能になります。これが、大規模なディープラーニングの学習処理で重要な役割を果たしています。
1-4. データセンター標準技術
InfiniBandは、クラウドやエンタープライズデータセンターでも標準インフラとして採用されています。特に、AI学習やHPCでは、InfiniBandが欠かせない技術となっています。2. InfiniBandの歴史と種類
InfiniBandは、2000年代初頭から進化を続けており、各世代で転送速度が大幅に向上してきました。以下、主要な世代を時系列でご紹介します。
▼図1 InfiniBandの歴史
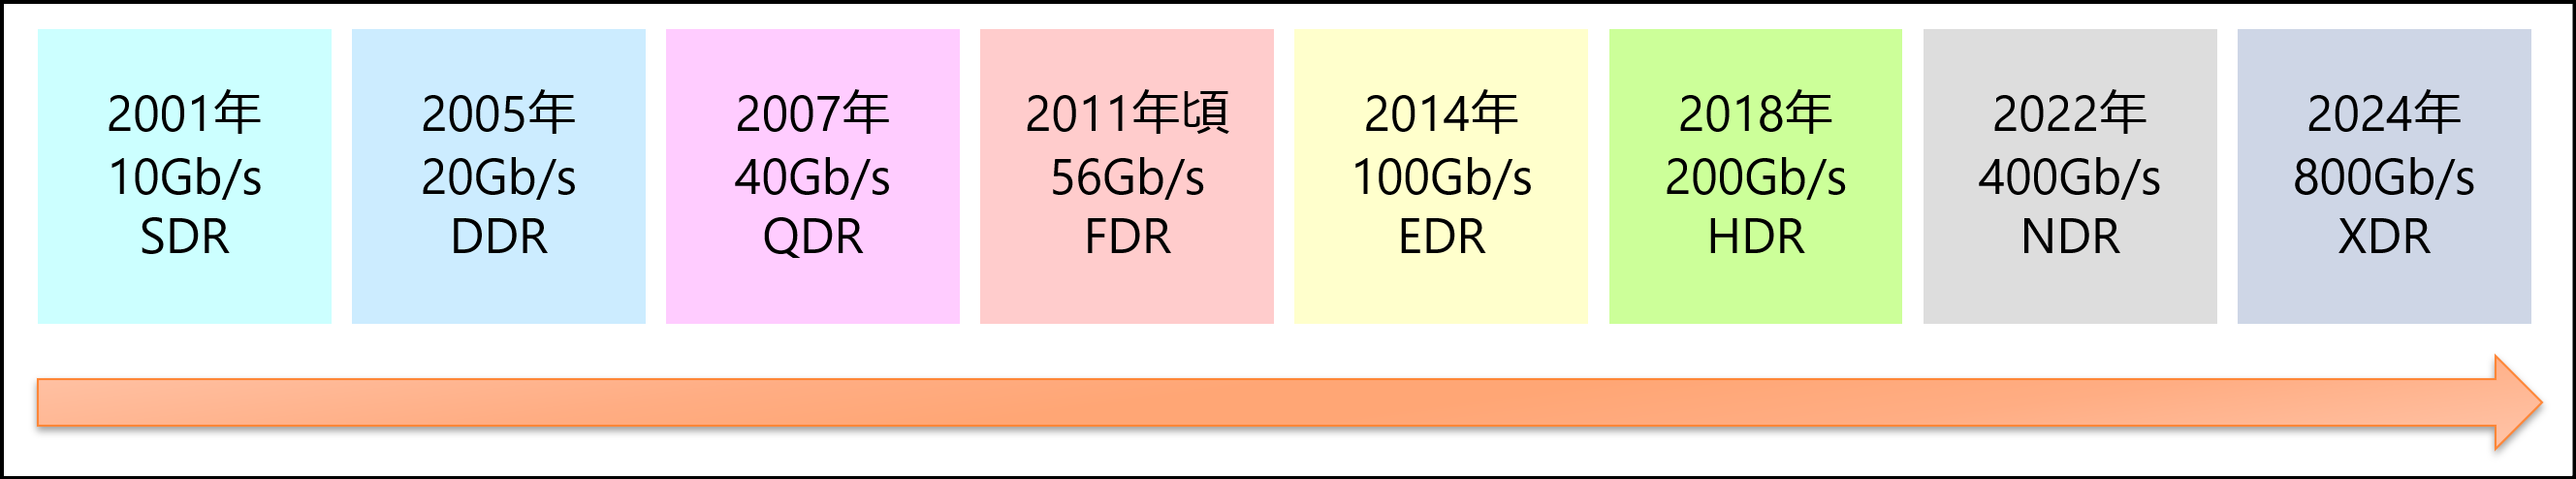
・SDR(Single Data Rate):10Gb/s(2001年頃に登場)
1レーンあたり2.5Gb/s×4レーン=10Gb/s(公称)でした。HPCの専用ネットワークとして普及した最初の世代です。
・DDR(Double Data Rate):20Gb/s(2005年頃に登場)
1レーンあたり5Gb/s、4Xポートで公称20Gb/sに向上した世代です。SDRの約2倍の帯域となり、MPIベースのHPCクラスターへ普及し始めました。
・QDR(Quad Data Rate):40Gb/s(2007–2008年)
1レーンあたり10Gb/s、4Xポートで公称40Gb/sに向上した世代です。この頃から、Top500に掲載される大規模スーパーコンピューターでInfiniBandの採用が拡大しました。
・FDR(Fourteen Data Rate):56Gb/s(2011年頃)
1レーンあたり約14.1Gb/s、4Xポートで公称約56Gb/sを実現した世代です。FDR対応アダプターはPCIe 3.0に対応し、サーバーのバス帯域幅を効率的に利用できるようになり、HPC分野での採用がさらに加速しました。
・EDR(Enhanced Data Rate):100Gb/s(2014–2015年)
1レーンあたり25Gb/s、4Xポートで100Gb/sを実現した世代です。RDMAとNCCL(NVIDIA Collective Communications Library)などの技術と組み合わさることで、ディープラーニングの裏方として重要な役割を果たしました。
・HDR(High Data Rate):200Gb/s(2019年)
1レーンあたり50Gb/s、4Xポートで200Gb/sを実現した世代です。NVIDIA/Mellanox ConnectX®-6とQuantumスイッチがリリースされ、大規模HPCおよびAIクラスターで採用が拡大しました。
・NDR(Next Data Rate):400Gb/s(2022年)
1レーンあたり100Gb/s、4Xポートで400Gb/sを実現する世代です。NVIDIA/Mellanox ConnectX®-7とNVIDIA Quantum-2スイッチが対応します。HDR/NDR以降の世代では、AI学習に対する影響が大きく、特にGPUDirect RDMAと小さなパケットのやり取りを得意とするInfiniBandの特性が生かされています。
・XDR: 800Gb/s
XDRは1レーンあたり200Gb/s、4Xポートで800Gb/sを実現する次世代のInfiniBandです。NVIDIA Quantum-X800スイッチとConnectX-8 SuperNICの組み合わせにより、エンドツーエンドで800Gb/sの接続に対応します。ConnectX-9 SuperNICも、Quantum-X800などの次世代AIネットワークプラットフォームに対応する製品として展開されています。
3. Ethernetとの違い
InfiniBandとEthernetは、いずれもAI/HPCのノード間通信に利用できます。ここでは、専用AI/HPCファブリックであるNVIDIA Quantum InfiniBand(Quantum-X800を含む)と、RoCEを統合・最適化したAI向けEthernetであるNVIDIA Spectrum-X Ethernetを主軸に比較します。ここまで記載したとおり、InfiniBandはネイティブRDMA、低レイテンシ、予測可能な性能に強みがあります。一方、NVIDIA Spectrum-X Ethernetは、標準Ethernetを基盤にRoCEを最適化し、スイッチとSuperNICを協調させることでAIワークロード向けの高帯域・低遅延・輻輳制御を実現します。どちらを選ぶかは、専用AI/HPCクラスタとしての性能・予測性を優先するか、既存Ethernet運用との統合や柔軟性を重視するかで判断してください。
| 項目 | InfiniBand(Quantum-X800) | AI向けEthernet(Spectrum-X) |
|---|---|---|
| 主な用途 | AI/HPCクラスター 低遅延な通信 |
企業LAN/クラウド全般 既存IP資産の活用 |
| レイテンシ | サブµs(0.5〜1µs) | 数µs〜数十µs |
| 帯域幅 | 400Gb/s(NDR)/800Gb/s(XDR) | 400〜800GbE |
| RDMA | ネイティブ搭載 | Spectrum-XによりRoCEを統合・最適化 |
| コスト/互換性 | 専用ファブリック・機器単価は高め | 既存Ethernetとの親和性 |
4. NVIDIA DOCA vs MLNX_OFED
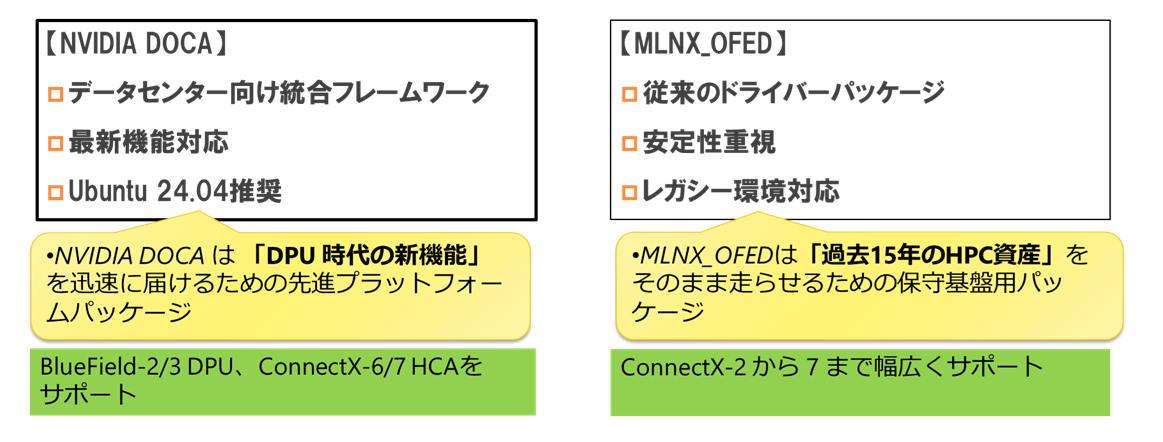
InfiniBandドライバーには、NVIDIA DOCAとMLNX_OFEDの2種類があります。どちらを使うべきか、簡単に説明します。4-1. MLNX_OFEDとは
MLNX_OFEDは、NVIDIAに買収される前のMellanox社が提供していたドライバーパッケージです。長年、InfiniBand環境の標準として使われてきました。4-2. NVIDIA DOCAとは
NVIDIA DOCAは、2020年にNVIDIA社がMellanoxを買収した後に、NVIDIA BlueField DPUを中心に"SmartNIC時代の統合SDK"として新設したものです。DOCAは、単なるドライバーではなく、ネットワーク機能を加速するための包括的なソフトウェアプラットフォームです。4-3. どちらを使うべきか
基本的に、新規構築や既存環境の更新では、DOCAを使うことをおすすめします。DOCAはNVIDIAが今後も継続的にサポート・開発を進める方向性であり、最新機能やセキュリティアップデートも優先的に提供されます。| 項目 | NVIDIA DOCA | MLNX_OFED |
|---|---|---|
| 開発元 | NVIDIA | Mellanox(現NVIDIA) |
| 特徴 | 次世代の統合ソフトウェアプラットフォーム | 従来の標準ドライバー |
| 対応範囲 | InfiniBand/Ethernet+NVIDIA BlueField DPU活用 | InfiniBand/Ethernet基本機能 |
| 推奨 | 新規構築・最新環境 | 既存環境の維持・延命 |
5. NVIDIA DOCAインストール手順
ここからは、実際にDOCAをインストールする手順を説明します。Ubuntu 24.04を例に、ステップバイステップで解説します。5-1. DOCAパッケージダウンロードページ
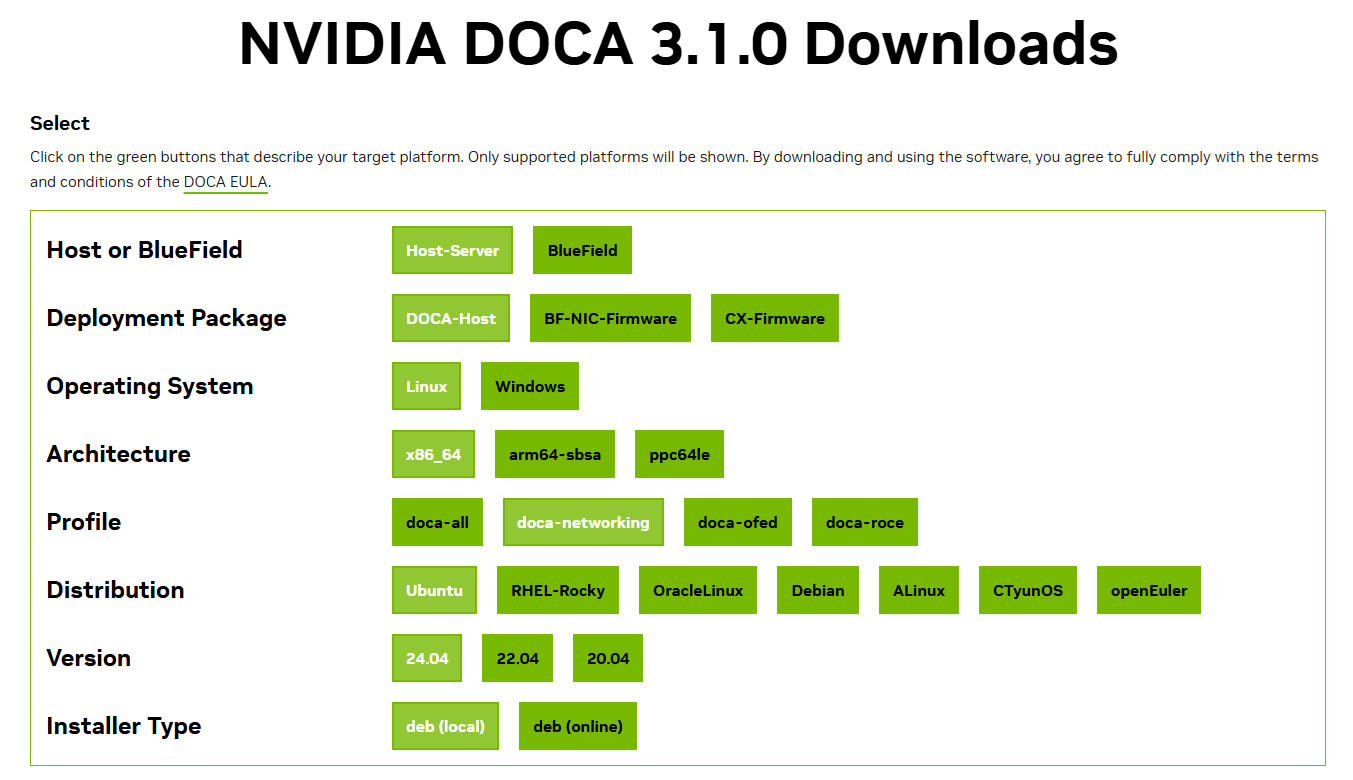
まず、NVIDIAの公式ダウンロードページにアクセスします。NVIDIA公式ダウンロードページ:https://developer.nvidia.com/doca-downloads
その後、以下の順序で選択を進めます。
「Host-Server」>「DOCA-Host」>「Linux」>「x86_64」>「doca-networking」>「Ubuntu」>「24.04」>「deb(local)」
5-2. DOCAパッケージダウンロード
ダウンロードページに表示されるインストール手順に従って、パッケージをダウンロードします。以下はDOCA v3.1.0の場合の例です(バージョンは最新のものを使用してください)。
wget https://www.mellanox.com/downloads/DOCA/DOCA_v3.1.0/host/doca-host_3.1.0-091000-25.07-ubuntu2404_amd64.deb
5-3. パッケージインストール
ダウンロードしたパッケージをインストールします。sudo dpkg -i doca-host_*.deb
sudo apt update
※ファイル名はダウンロードしたバージョンに合わせて適宜変更してください(例:sudo apt update
doca-host_3.1.0...)。
5-4. DOCA Networkingインストール
DOCA Networkingをインストールします。sudo apt -y install doca-networking
5-5. 再起動
インストールを完了するために、システムを再起動します。sudo reboot
5-6. インストール後の確認
再起動後、以下のコマンドでインストールが正常に完了したか確認できます。# InfiniBandデバイスの確認
ibstat
# InfiniBandインターフェースの確認
ip addr show
# ドライバーのバージョン確認
modinfo mlx5_core
ibstat
# InfiniBandインターフェースの確認
ip addr show
# ドライバーのバージョン確認
modinfo mlx5_core
正常にインストールされていれば、InfiniBandデバイスが認識され、ネットワークインターフェースが表示されます。
5-7. トラブルシューティング
インストール後にデバイスが認識されない場合は、以下の点を確認してください。- ハードウェアの接続確認:PCIeスロットに正しく接続されているか
- ファームウェアの確認:
mlxfwmanagerコマンドでファームウェアの状態を確認 - ログの確認:
dmesg | grep -i mlxでカーネルログを確認 - ドライバーのロード確認:
lsmod | grep mlxでドライバーモジュールがロードされているか確認
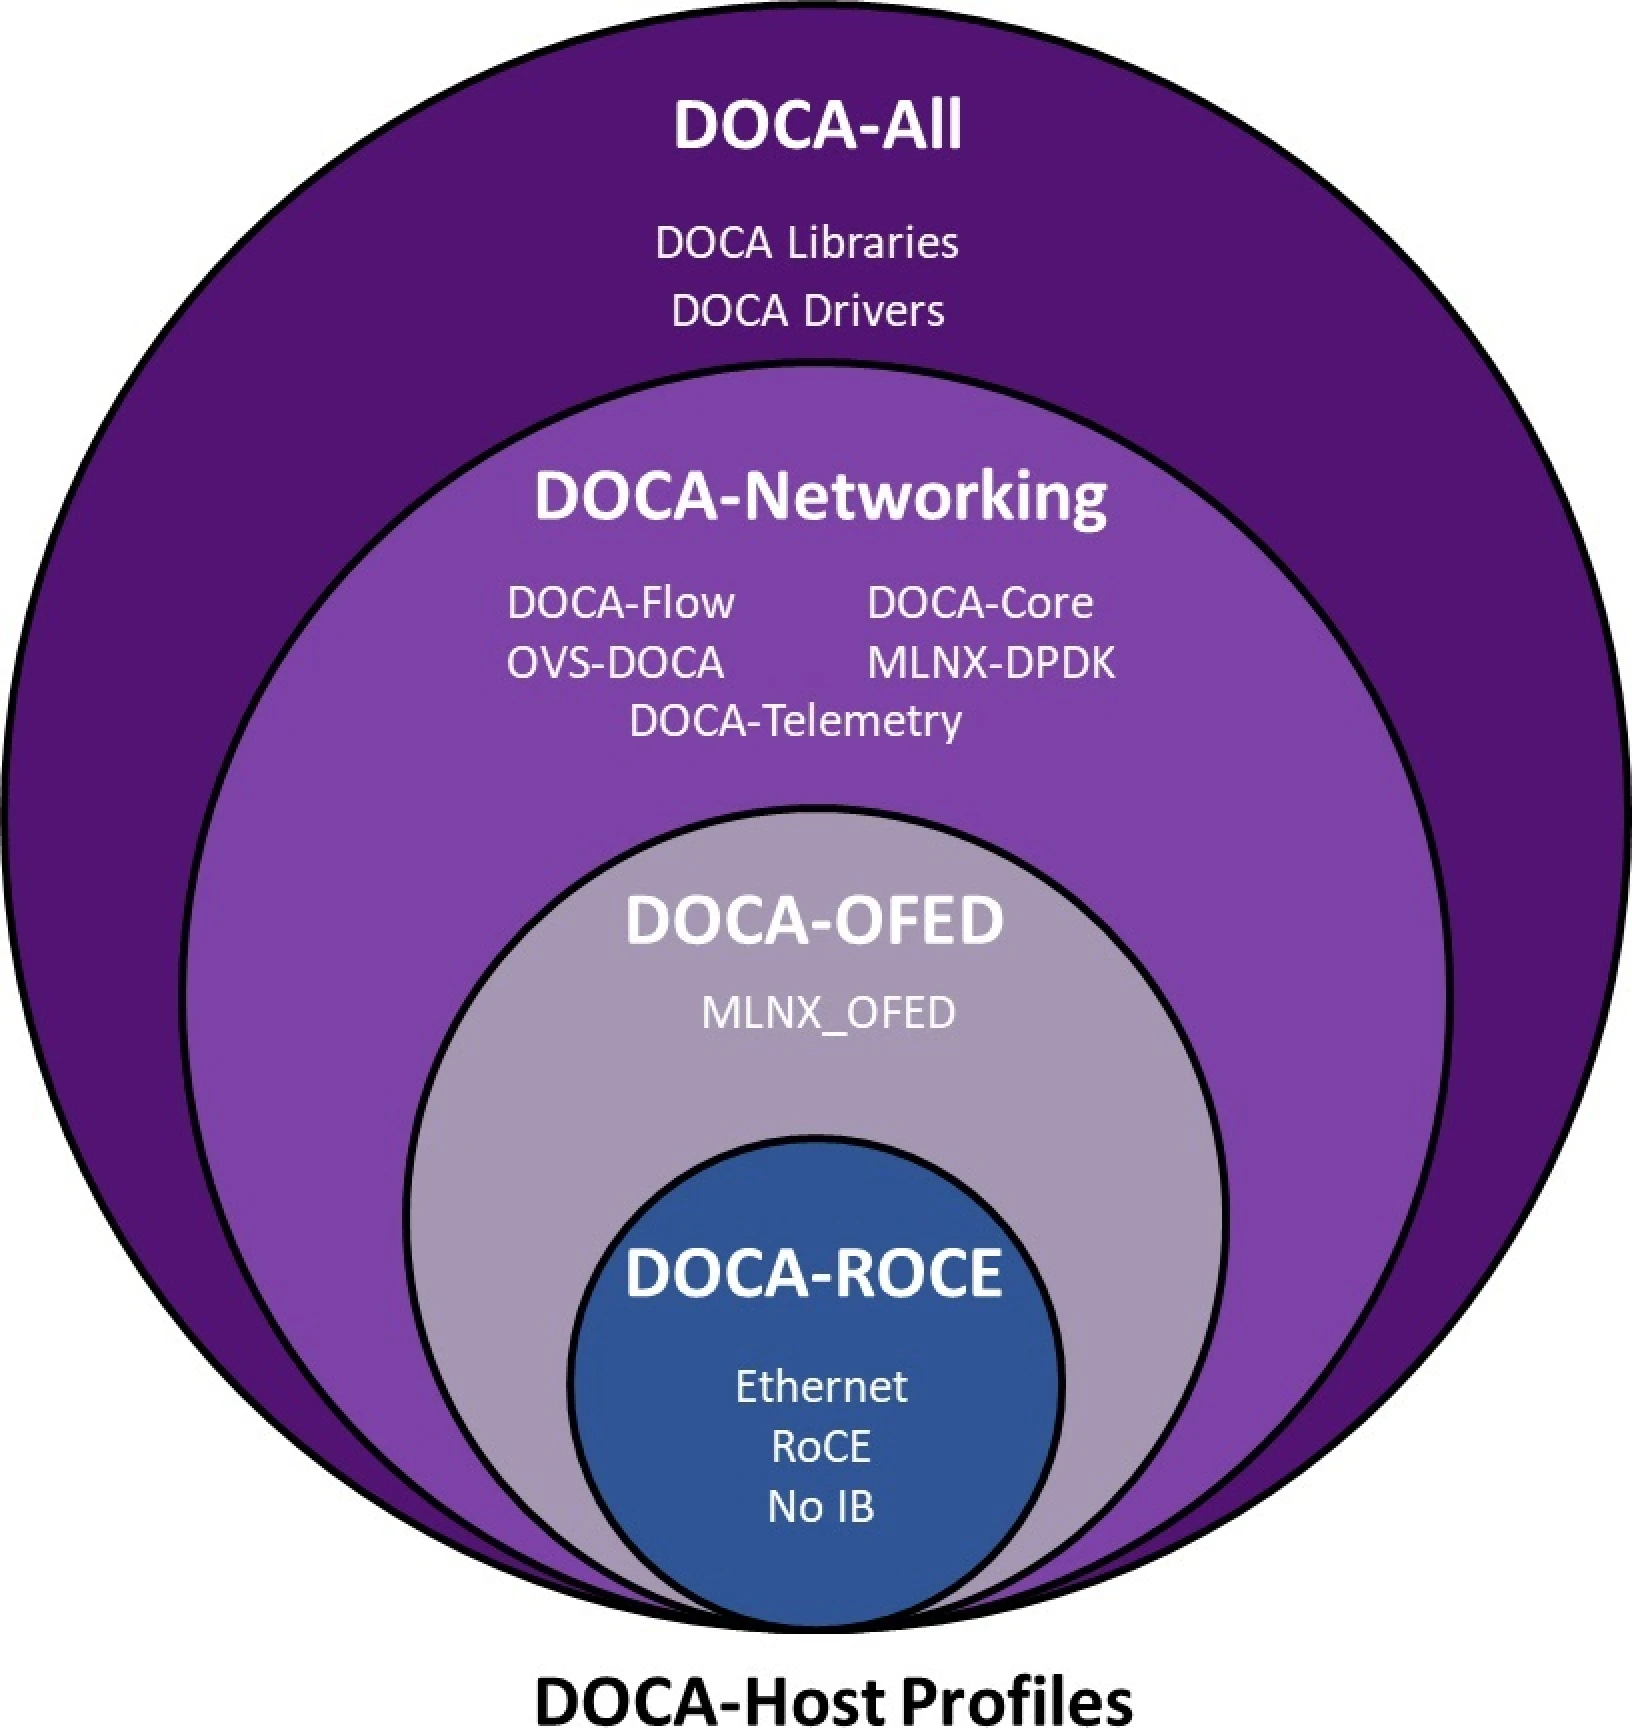
DOCAドライバーには、用途に応じて4種類のプロファイルが用意されています。ユースケースに応じたパッケージを選択することで、不要なコンポーネントをインストールせずに済み、アップデートもスムーズになります。
| プロファイル | 含まれる主なコンポーネント | ユースケース |
|---|---|---|
| DOCA-ALL | すべてのDOCAライブラリ・ユーティリティ・ドライバ(InfiniBand/Ethernet/RoCE/NVIDIA BlueField DPU向け機能・サンプル・SDKなどフルセット) | NVIDIA BlueField DPUを活用しながらアプリ開発も行うAI/HPCクラスター 「とりあえず全部入りで最新機能を試したい」 |
| DOCA-Networking | DOCA-OFEDに追加してDOCA Core、MLNX-DPDK、OVS-DOCA、DOCA Flow、DOCA-Telemetryを追加 | ホストサーバ/スーパーNIC運用 「DOCAのネットワーク加速機能が欲しい」 |
| DOCA-OFED | 旧MLNX_OFEDと同等のカーネルドライバ・ユーザーランドツール一式のみ DOCA SDKや追加ライブラリは含まず、操作感をMLNX_OFEDと完全互換 |
既存OFEDベースのHPCクラスターを「とにかく壊さず」延命・更新したい現場 |
| DOCA-ROCE | Ethernet+RoCEドライバだけを抜粋した最小サブセット InfiniBand部分は非搭載 |
IBを使わないAIクラウドやコンテナネットワークで、RoCEのみ利用するケース |
参考: DOCA Profiles - NVIDIA Docs
6. よくある質問
Q. DOCAとMLNX_OFEDの違いは何ですか?A. DOCAはNVIDIAが2020年以降に開発を進めている新しいプラットフォームで、MLNX_OFEDはMellanox時代のドライバーパッケージです。新規構築ではDOCAを推奨しますが、既存のMLNX_OFED環境を維持する必要がある場合は、DOCA-OFEDプロファイルを使用することで互換性を保てます。
Q. どのプロファイルを選べばよいですか?
A. 一般的なHPCやAIクラスター環境では、DOCA-OFEDまたはDOCA-Networkingが適しています。NVIDIA BlueField DPUを使う場合や、最新機能を試したい場合はDOCA-ALLを選択します。InfiniBandを使わずRoCEのみを使う場合はDOCA-ROCEが最適です。
Q. インストール後にパフォーマンスが期待通りでない場合は?
A. ファームウェアのバージョン、ネットワーク設定(MTUサイズなど)、アプリケーション側の設定(NCCLの設定など)を確認してください。また、GPUDirect RDMAを使う場合は、別記事で紹介しているDMA-BUFの設定も必要です。
Q. 既存のMLNX_OFED環境からDOCAに移行できますか?
A. はい、可能です。DOCA-OFEDプロファイルを使用することで、MLNX_OFEDと同等の機能を提供しつつ、NVIDIAのサポートを受けられます。移行前には、必ずテスト環境で動作確認を行うことをおすすめします。
7. まとめ
本コラムでは、InfiniBandからConnectXまでの簡単な概要と、最新のドライバーインストール方法について解説しました。MLNX_OFEDでのドライバーインストール方法については既に多くの記事がありますが、DOCAでのインストールは情報が少ないため、本コラムがご参考になれば幸いです。特に、大規模なAIクラスターやHPC環境を構築する際には、適切なドライバーの選択とインストールが重要です。用途に応じたプロファイルを選択し、最新の情報を確認しながら進めることをおすすめします。
関連ページはこちら:
-[NVIDIA DGX Sparkとは?③ デスク上の“データセンター”を実現するネットワークとソフトウェア]
-[GPUドライバーとは?NVIDIA GPUドライバーを徹底解説]
-[GPUトポロジーとは?マルチGPU環境で押さえるべき接続技術]
-[GPUDirectとは?2025年版GPUDirect RDMA-DMA-BUF最新情報をご紹介]
筆者プロフィール
矢野 哲朗(やの てつろう)
株式会社スタイルズ(リョーサン菱洋グループ会社)経歴:Kubernetesを中心としたクラウドネイティブ基盤の構築・支援を専門とし、株式会社スタイルズでオープンソースを軸に20年以上インフラに携わる。
Edge/AI分野でのGPU活用にも注力中。
専門分野:Kubernetes/Rancherによるクラウドネイティブ基盤構築、GPUを活用したEdge・AI案件の技術支援など
現場で得た知見をもとに、クラウドネイティブやEdge/GPU/AI技術をわかりやすく解説します。
#Kubernetes #CloudNative #EdgeComputing #GPU #Rancher #Nextcloud
公開日:
最終更新日: