目次
はじめに
前回のコラムでは、AI推論を本番環境で成立させるための重要な観点として、リアルタイム応答性、スケーラビリティ、相互運用性、コスト効率を整理しました。特に大規模言語モデル(LLM)では、トークン処理の効率とレイテンシが、ユーザー体験と総所有コスト(TCO)の両方を大きく左右します。今回は、2026年8月26日時点のNVIDIA公式情報をもとに、NVIDIA® TensorRT™、TensorRT-LLM、NVIDIA NIM™、Triton Inference Server、NVIDIA Dynamo、そして映像AI向けのNVIDIA Metropolis Blueprint for Video Search and Summarization(VSS)まで、役割と使い分けを整理します。これらは単純な上位・下位の製品系列ではありません。モデル最適化、LLM実行、APIサービング、運用パッケージ化、分散推論、映像AIパイプラインといった異なる役割を担い、要件に応じて単独または組み合わせて利用します。
1. AI推論を支えるNVIDIAソフトウェアスタックの全体像
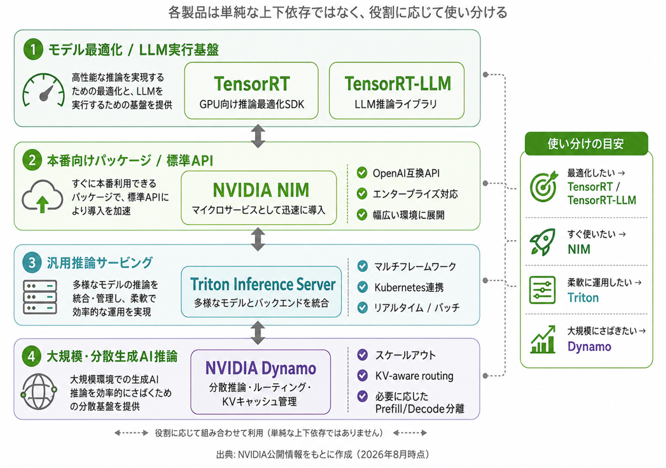
AIモデルを本番環境で効率よく動かすには、モデルそのものの最適化だけでなく、APIとしての提供、監視、スケールアウト、セキュリティ、ライフサイクル管理まで含めて設計する必要があります。NVIDIAは、これらの課題に対して役割の異なる推論ソフトウェアを提供しています。▼図1 NVIDIAの推論ソフトウェアの役割分担(2026年8月時点)
補足:LMM以外のモデル / 映像AIでの選択肢
▼図2 その他のユースケース
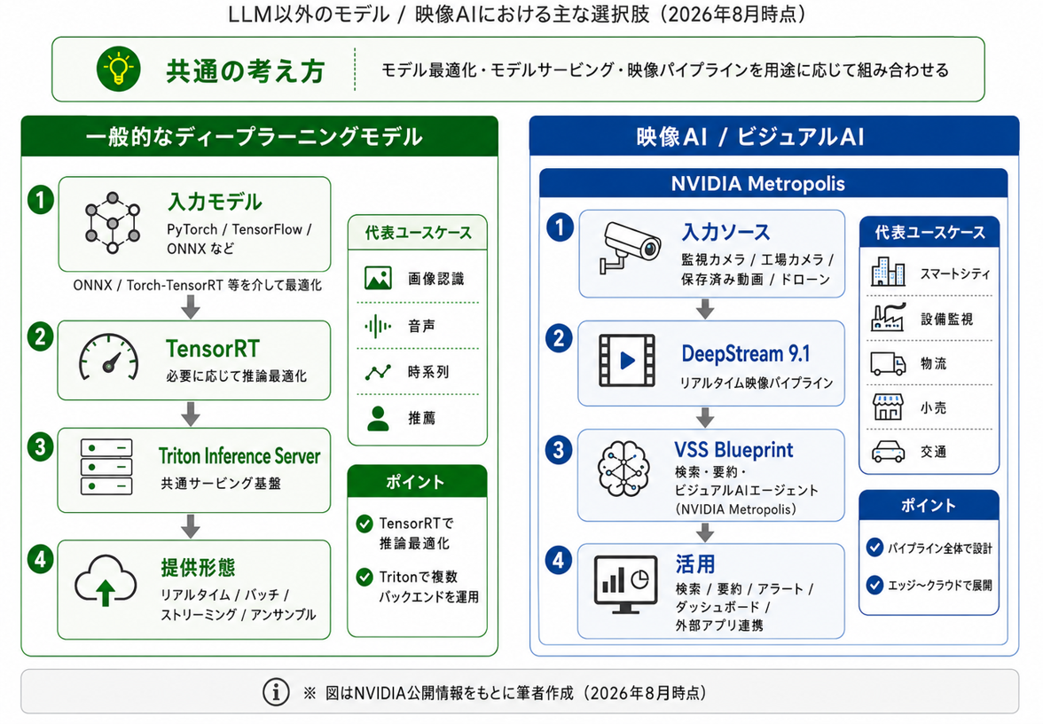
Triton Inference Serverは、TensorRT、PyTorch、ONNX Runtime、OpenVINO、Python、RAPIDS FILなど複数のバックエンドを共通のモデルサービング基盤で扱えます。モデル形式や運用要件に応じてバックエンドを選択でき、TensorRTで最適化可能なモデルではTensorRTバックエンドが有力な選択肢になります。
一般的なディープラーニングモデルでは、PyTorchモデルをONNXまたはTorch-TensorRT経由で、TensorFlowなどのモデルをONNX経由でTensorRTへ持ち込み、必要に応じて最適化します。サービングや複数モデルの一元管理が必要な場合はTriton Inference Serverを組み合わせます。一方、映像AIではDeepStream 9.1で映像の取り込み、前処理、リアルタイム推論などのパイプラインを構築し、自然言語による動画検索・要約やビジュアルAIエージェントまで実現したい場合は、NVIDIA MetropolisのVSS Blueprintを組み合わせます。
1-1. TensorRT / TensorRT-LLM
TensorRTは、NVIDIA GPU上でディープラーニング推論を高速化するための高性能SDKです。2026年8月26日時点の最新リリースはTensorRT 11.2.1です。学習済みモデルをGPU上で効率よく実行できるよう、グラフ最適化、レイヤー / 演算の融合、カーネル選択、動的シェイプ、各種精度・量子化への対応などを提供します。画像認識、音声、時系列、推薦など、幅広いディープラーニング推論を最適化する中核コンポーネントと考えると分かりやすいでしょう。▼図3 TensorRTとTensorRT-LLMの役割と位置づけ
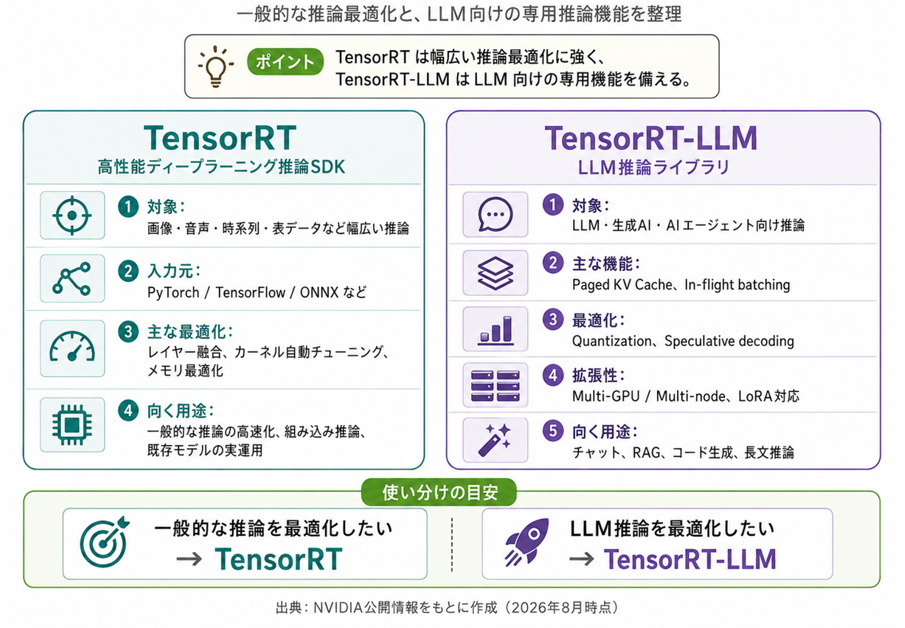
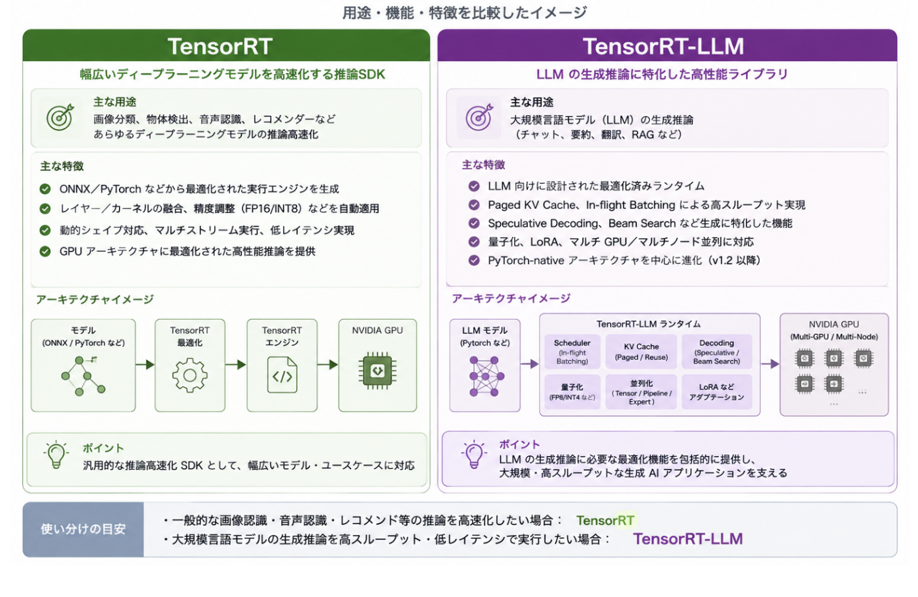
TensorRT-LLMは、LLM推論をNVIDIA GPU上で高速化・効率化するためのオープンソースライブラリです。Paged KV Cache、KV Cache Reuse、In-flight Batching、Chunked Prefill、量子化、LoRA、Speculative Decoding、マルチGPU / マルチノードなど、LLM特有の機能を備えています。2026年8月時点のTensorRT-LLM 1.2では大きなアーキテクチャ変更があり、従来のTensorRT実行バックエンドが削除され、PyTorchが唯一の実行バックエンドになりました。そのため現在は、「TensorRTをLLM向けに単純拡張したもの」と説明するより、LLM推論専用の最適化・実行ライブラリとして捉える方が正確です。
つまり、TensorRTとTensorRT-LLMは単純に性能を競う製品ではありません。TensorRTは幅広いディープラーニング推論の最適化、TensorRT-LLMはLLM固有の推論処理とサービング最適化を主な対象としています。図4では、この対象と役割の違いを整理しています。
▼図4 TensorRTとTensorRT-LLMの比較
LLM推論の性能は、モデル、GPU、量子化方式、入力シーケンス長(ISL:Input Sequence Length)、出力シーケンス長(OSL:Output Sequence Length)、同時実行数、KVキャッシュ再利用率などによって大きく変化します。評価では、TTFT(Time to First Token:最初のトークンが返るまでの時間)、TPOT(Time Per Output Token:出力トークン1個あたりの時間)、ITL(Inter-Token Latency:トークン間レイテンシ)、スループット、GPU使用率などを確認します。そのため「TensorRT-LLMを使えば一律で何倍高速になる」と固定値で表現するのではなく、対象ワークロードでこれらの指標を測定して判断することが重要です。なお、通常のKVキャッシュは主にデコード時の再計算を避ける仕組みであり、共通プレフィックスをリクエスト間で再利用するKV Cache Reuseを利用すると、条件によってTTFT短縮も期待できます。
参考:NVIDIA TensorRT Documentation、NVIDIA TensorRT-LLM Documentation(2026年8月26日時点)
1-2. NVIDIA NIM
NVIDIA NIM for Large Language Models(NIM LLM)は、LLMをOpenAI互換APIで提供しやすい形にパッケージ化した推論マイクロサービスです。2026年8月時点ではNIM LLM 2.xと3.0が並行して提供されています。2.xは単一コンテナ構成が基本で、3.0ではNVIDIA Dynamoを利用する分散推論アーキテクチャをオプションとして追加しています。▼図5 NVIDIA NIM LLMの構成(2.xと3.0 / Dynamo mode)
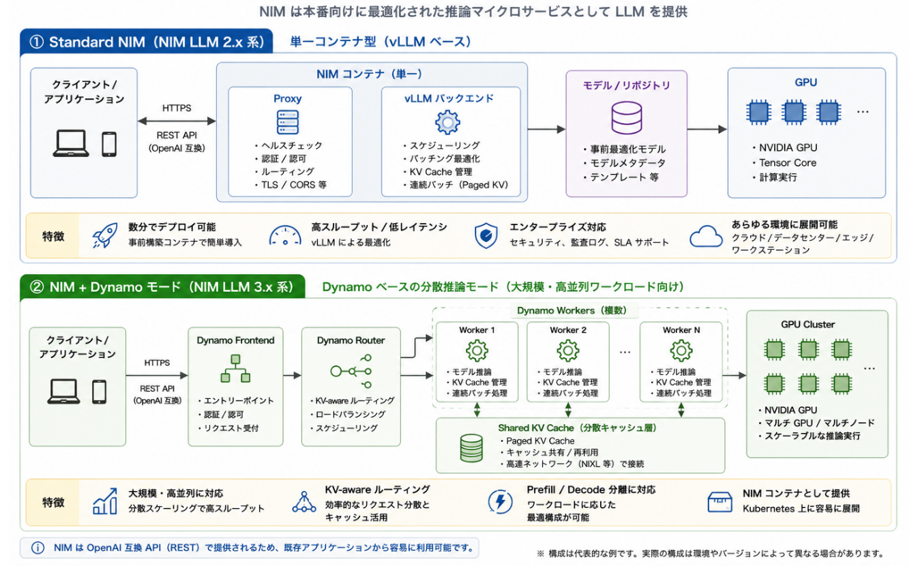
図5では、NIM LLM 2.xの単一コンテナ構成と、NIM LLM 3.0で追加されたDynamo modeを対比しています。NVIDIA公式ドキュメントでは「standard mode」や「standard NIM 2.0 configuration」という表現が使われています。ただし、これらは構成を指す用語であり、「Standard NIM」という別製品や別の提供形態を意味するものではありません。NVIDIAが定義する提供形態は「NIM」と「NIM Certified」です。
アーキテクチャ:NIM LLM 2.xは、プロキシ/管理層と単一の推論バックエンドを1つのコンテナにまとめる構成が基本です。バックエンドはイメージによりvLLMまたはSGLangを利用します。NIM LLM 3.0でもDynamo関連のモード指定を行わなければ、NVIDIA公式が「standard mode」と呼ぶ単一コンテナ動作で起動できます。一方、Dynamo modeはvLLMベースで、OpenAI互換のフロントエンド/ルーターと、独立してスケールできるワーカーに分離されます。図5はvLLMを利用する代表的な構成例です。
モデルの提供形態:NIM LLMにはModel-Specific NIMとModel-Free NIMがあります。Model-Specific NIMは、対象モデル向けのマニフェスト、検証済みプロファイルや実行設定を備え、対応モデルを短時間で展開したい場合に適しています。Model-Free NIMは、利用するNIMバックエンドが対応するモデルを、Hugging Face、S3、ローカルディレクトリなどから指定して提供したい場合の選択肢です。
デプロイと運用:NIMはOpenAI互換APIに加えて、Liveness / Readiness、メトリクス、ログなどの運用機能を提供します。Kubernetes、KServe、OpenShift、NIM Operator、主要クラウドなど複数の展開方法が公式ドキュメントで案内されています。また、インターネット接続を持たない隔離環境向けには、Air-Gap Deploymentの手順も提供されています。
性能:NIMはモデルとGPUに応じた検証済みプロファイルを利用し、推論エンジンの設定やモデル配置を簡素化します。ただし、性能向上率はモデル、GPU、ISL/OSL、並列度などに依存します。特定の倍率を一般化せず、対象ワークロードでTTFT、TPOT / ITL、スループット、GPU使用率などを測定して評価することが重要です。
バージョン系列:NIM LLM 2.xと3.0は並行して提供されており、どちらか一方が他方を置き換える関係ではありません。単一コンテナでの運用を重視する場合は2.x / standard mode、大規模な分散推論が必要な場合は3.0のDynamo modeが選択肢になります。3.0でもDynamo modeを有効にしない場合はstandard modeで動作します。
エンタープライズ対応:NVIDIAは提供形態として「NIM」と「NIM Certified」を区別しています。NIMは新しいモデルへの迅速なアクセスを重視し、無償で利用できますが、NVIDIA Enterprise Supportの対象ではありません。NIM Certifiedは企業の本番利用向けで、広いハードウェア検証、CVE対応、Feature Branch/Production Branchといった企業向けライフサイクルを提供します。Feature Branchは無償で利用でき、Enterprise Supportを利用する場合はNVIDIA AI Enterpriseサブスクリプションが必要です。Production Branchは同サブスクリプションが必要です。なお、NIM LLM 3.0.0はNIM Certifiedではありません。
このようにNIMは、単に「モデルを入れたコンテナ」ではなく、LLM推論をAPIとして提供するためのプロファイル管理、ヘルスチェック、可観測性、セキュリティ設定、デプロイ手段をまとめた運用パッケージです。新しいモデルを素早く試すのか、長期運用と企業サポートを重視するのかによって、NIM/NIM Certified、2.x / 3.0、standard mode / Dynamo modeを選び分けることが重要です。
1-3. Triton Inference Server
Triton Inference Serverは、複数のAI / MLフレームワークや推論ランタイムを共通のサービング基盤で運用するためのオープンソース推論サーバーです。TensorRT、PyTorch、ONNX Runtime、OpenVINO、Python、RAPIDS FIL、vLLM、TensorRT-LLMなど、用途に応じて異なるバックエンドを利用できます。▼図6 Triton Inference Server 概念図
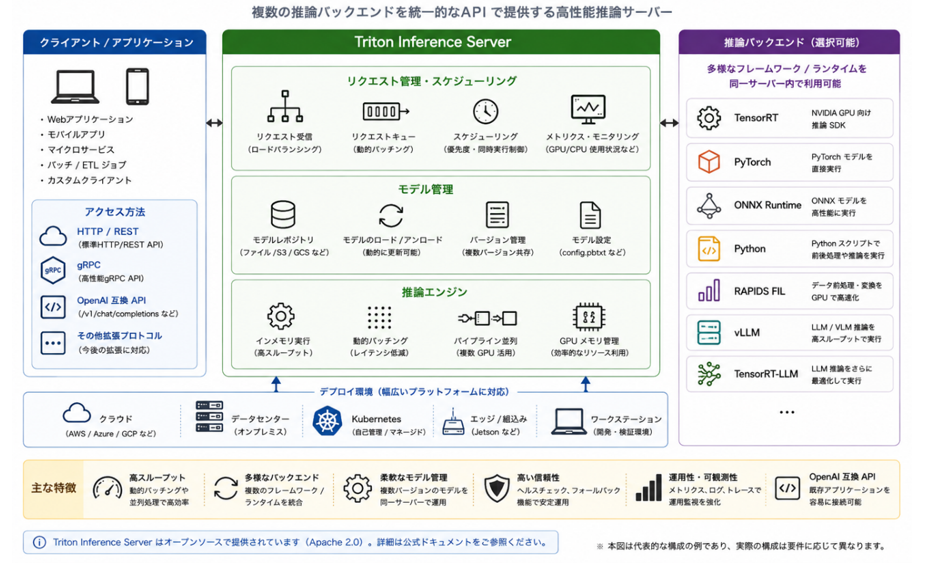
LLMやVLMについても、vLLMやTensorRT-LLMなどの対応バックエンドを使ってサービングできます。また、TritonにはOpenAI互換フロントエンドが用意されており、/v1/chat/completions、/v1/completions、/v1/embeddingsなどのAPIでアプリケーションと連携できます。
Tritonはクラウド、データセンター、エッジなど幅広い環境で利用できます。ただし、利用できるCPU / GPU、OS、Jetsonを含むプラットフォームや機能はバックエンドとリリースによって異なるため、実際の導入時はCompatibility Matrixを確認する必要があります。
多様なバックエンド:TensorRT、PyTorch、ONNX Runtime、OpenVINO、Python、RAPIDS FIL、vLLM、TensorRT-LLMなどを用途に応じて選択できます。
多様なサービング方式:リアルタイム、バッチ、ストリーミング、アンサンブルなどの推論パターンに対応し、複数モデルを1つのサーバー基盤で管理できます。
柔軟な配置:NVIDIA GPUだけでなくCPU上で動作するバックエンドもあり、クラウド、オンプレミス、エッジへ展開できます。実際の機能と性能はモデル、バックエンド、ハードウェア構成に依存します。
DevOps/MLOpsとの統合:KubernetesやKServeと組み合わせた運用、Prometheusメトリクスによる監視、モデルの動的ロード/アンロードなどを利用できます。
つまりTritonは、対応LLMを迅速にAPIとして提供するNIMとは役割が異なり、複数のモデル形式や推論ランタイムを共通の運用基盤で管理したい場合に強みを持つモデルサーバーです。
1-4. NVIDIA Dynamo
NVIDIA Dynamoは、生成AIを高スループット、低レイテンシ、高い信頼性で大規模運用するためのオープンソース分散推論プラットフォームです。2026年3月12日にv1.0がGAとなり、2026年8月26日時点ではv1.4系(最新パッチはv1.4.1)が公開されています。vLLM、SGLang、TensorRT-LLMをバックエンドとして利用でき、Kubernetesやローカル環境で、ルーティング、スケーリング、KVキャッシュ活用、Prefill / Decode分離など推論パイプライン全体を最適化します。▼図7 NVIDIA Dynamo概念図
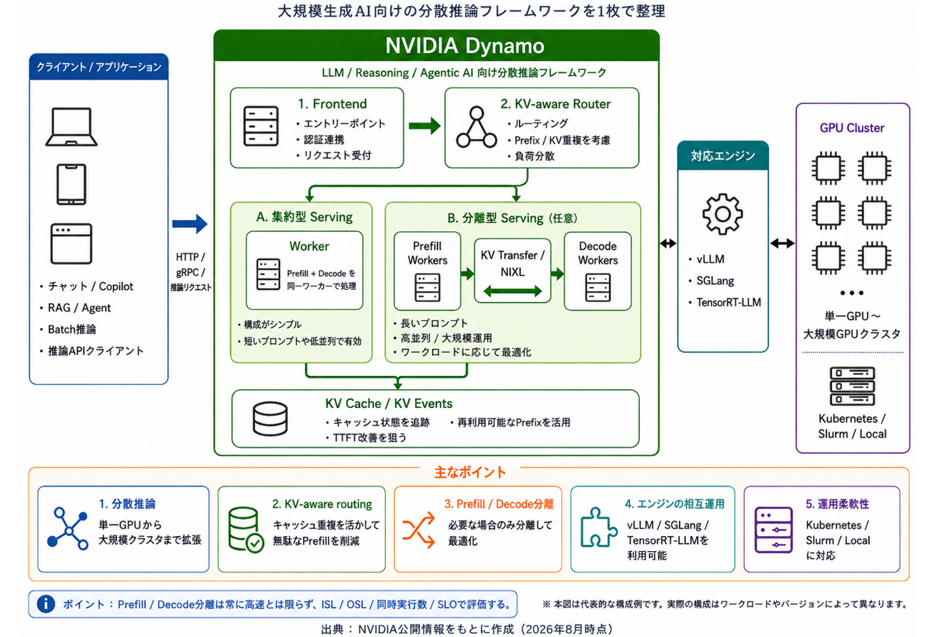
分散推論:単一GPUから大規模GPUクラスタまでワーカーを増減しながら生成AI推論をスケールできます。PrefillとDecodeを同一ワーカーで処理する集約型と、別ワーカー群へ分離する分離型の双方を構成できます。
配置・スケーリング:トラフィックやSLO(Service Level Objective:サービスレベル目標)に応じてワーカーの配置と拡張を行い、GPUリソースの過剰な割り当てや不足を抑えることを狙います。
KV-aware routing:各ワーカーが保持するKVキャッシュとリクエストのプレフィックスの重なりを考慮してルーティングし、不要なPrefill再計算を減らします。単純に「似たリクエストをまとめる」仕組みではありません。
推論エンジンの相互運用:vLLM、SGLang、TensorRT-LLMなどを利用できるため、モデルや性能要件に合わせて推論エンジンを選択できます。
KVキャッシュ管理:Dynamoはワーカー側のKVキャッシュ状態をルーティングに利用し、構成に応じてKVBM(KV Block Manager)やバックエンド固有のオフロード機能も利用できます。Prefill / Decode分離ではNIXL(NVIDIA Inference Xfer Library:推論データ転送ライブラリ)などを用いたKV転送を組み合わせる構成があります。
なお、Prefill / Decode分離は常に最速になるわけではありません。短いプロンプト、小規模モデル、低い同時実行数では集約型の方がシンプルで高速な場合もあります。実際のISL / OSL、並列度、TTFT / TPOTのSLOを使って比較することが重要です。
Dynamoはv1.0でGAとなった後も継続的に更新されており、2026年8月26日時点ではv1.4系が提供されています。NIM LLM 3.0ではDynamo modeも選択できます。なお、NIM LLM 3.0.0はNIM Certifiedではないため、NVIDIA Enterprise Supportが必要な場合は、NIM Certifiedの対象バージョン/モデルをSupport Matrixで確認してください。
1-5. NVIDIA Metropolis Blueprint for Video Search and Summarization (VSS)
NVIDIA Metropolisは、映像やセンサーデータを取り込み、リアルタイム解析から自然言語による検索・要約、ビジュアルAIエージェントまでを構築するためのプラットフォームです。2026年時点では、リアルタイム映像パイプラインを担うNVIDIA DeepStream 9.1、動画検索・要約を担うVSS Blueprint、さらにNVIDIA NIM、NVIDIA TAO、NVIDIA Cosmos™ 系技術などを組み合わせてビジュアルAI基盤を構成します。▼図8 NVIDIA Metropolis Blueprint for Video Search and Summarization(VSS)概念図
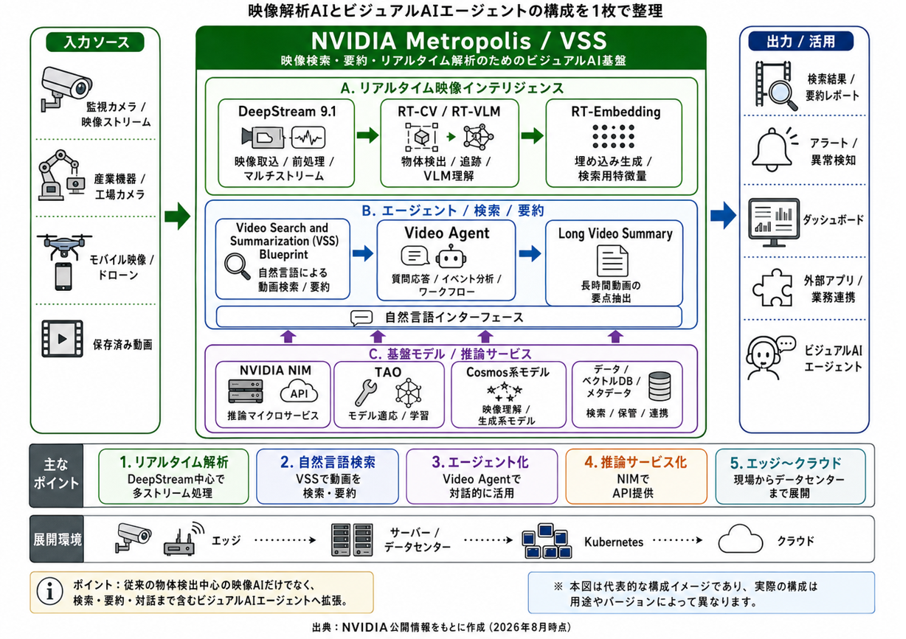
図8は、映像AIの流れを理解しやすくするために筆者が機能レイヤーとして整理した概念図です。リアルタイム映像処理はDeepStream 9.1を中心に、映像の取り込み・前処理・推論・メタデータ生成などを担います。動画の自然言語検索・要約や長時間動画のイベント抽出にはVSS(Video Search and Summarization)やLong Video Summarizationなどを組み合わせ、必要に応じてNVIDIA NIM、TAO、Cosmos系モデル、ベクトルDB / メタデータ基盤と連携します。図中のレイヤー名は製品境界を示す公式アーキテクチャ名ではなく、役割を示すための整理です。
この構成により、監視カメラ、工場カメラ、ドローン、保存済み動画など多様な入力から、検索結果や要約レポート、アラート、ダッシュボード、外部アプリ連携、ビジュアルAIエージェントまでを一貫したパイプラインとして構成できます。活用領域は、スマートシティ、工場・設備監視、物流・倉庫、小売、交通、建設などです。従来の物体検出中心の映像AIから、検索、要約、対話、判断までを含むエージェント型の活用へ広がっています。
2. まとめ
NVIDIAの推論ソフトウェアは、単純な製品の階層ではなく、役割の異なるコンポーネントを組み合わせて利用する構成です。TensorRTは幅広いディープラーニング推論を最適化するSDK、TensorRT-LLMはLLM推論専用の最適化・実行ライブラリ、Triton Inference Serverは複数バックエンドを統合するモデルサーバー、NVIDIA NIMはLLM推論をAPIとして利用しやすい形で提供するマイクロサービス、NVIDIA Dynamoは大規模生成AI向けの分散推論プラットフォームという位置づけです。映像AIでは、NVIDIA VSS Blueprintが、リアルタイム映像解析から検索・要約・ビジュアルAIエージェントまでを支える別軸のプラットフォームとして機能します。実際の選定では、「どの製品が最も速いか」だけでなく、モデルの種類、どこまで構成を制御したいか、同時実行数、ISL / OSL、TTFT / TPOTのSLO(Service Level Objective:サービスレベル目標)、運用体制、エンタープライズサポートの要否を基準に考えます。2026年時点では、NIM LLM 2.x / 3.0、standard mode / Dynamo mode、NIM / NIM Certified、Dynamoの集約型 / 分離型など複数の選択肢があり、「用途に合わせて組み合わせる」という考え方が重要です。
以下の表1に、2026年8月26日時点の主要コンポーネントの役割を整理します。
▼表1 各ソリューションの比較表
| ソリューション | 主な役割 | 向いているケース | 配置・拡張 | 2026年時点のポイント |
| TensorRT | NVIDIA GPU向けディープラーニング推論SDK | 画像・音声・一般的なDLモデルの最適化 | 対応GPU上で最適化済み推論を実行 | 最新は11.2.1。グラフ最適化、動的シェイプ、カーネル選択、各種精度・量子化など |
| TensorRT-LLM | LLM推論の最適化・実行ライブラリ | LLMを細かく制御し高性能に運用 | 単一GPU〜マルチGPU / マルチノード。Triton / Dynamoと連携 | 1.2ではTensorRT実行バックエンドを削除しPyTorchが唯一の実行バックエンド |
| NVIDIA NIM | LLM推論をAPIとして提供するマイクロサービス | 対応モデルを短時間でAPI化。NIM Certifiedは企業の本番運用向け | 2.xは単一コンテナ。3.0はstandard modeまたはDynamo mode | NIMとNIM Certifiedは別提供。Feature BranchのEnterprise Support / Production BranchはNVIDIA AI Enterprise条件を確認 |
| Triton Inference Server | 複数バックエンドを統合するモデルサーバー | 複数モデル/フレームワークを共通基盤で提供 | クラウド、データセンター、エッジ、Kubernetes | OpenAI互換フロントエンドを提供。vLLM / TensorRT-LLM等を利用可能 |
| NVIDIA Dynamo | 大規模生成AI向け分散推論プラットフォーム | 大規模LLM、Reasoning、Agentic AIのスケール運用 | 集約型 / Prefill-Decode分離、Kubernetes / Slurm/ローカル | 集約型/Prefill-Decode分離、Kubernetes / Slurm / ローカル v1.0 GA。2026年8月26日時点はv1.4系(最新パッチv1.4.1)。KV-aware routing、KV cache、vLLM / SGLang / TensorRT-LLM対応 |
| NVIDIA Metropolis Blueprint for Video Search and Summarization(VSS) | 映像解析・ビジュアルAIエージェント基盤 | 動画検索 / 要約、監視、製造・物流・都市など | エッジ〜クラウド | VSS Blueprint、DeepStream 9.1、NIM、TAO、Cosmos系技術などを組み合わせて構成 |
※本稿は2026年8月26日時点のNVIDIA公式公開情報を基準に更新しています。製品のサポート範囲や互換性は更新されるため、導入時には各製品のRelease Notes / Support Matrixを確認してください。
~参考情報|NVIDIA公式ドキュメント(2026年8月26日時点)~
| 目的 | 主な選択肢 |
| 一般的なDL推論を最適化 | TensorRT |
| LLM推論を細かく最適化 | TensorRT-LLM |
| 対応LLMを迅速にAPI化 | NVIDIA NIM |
| 複数モデル / バックエンドを共通運用 | Triton Inference Server |
| 大規模な生成AI推論を分散運用 | NVIDIA Dynamo |
| 映像解析・検索・要約・ビジュアルAI | NVIDIA Metropolis / DeepStream / VSS |
| カテゴリ | 公式ドキュメント |
| TensorRT | TensorRT Documentation | TensorRT 11.2.1 Release Notes |
| TensorRT-LLM | Release Notes | TensorRT Backend Removed Migration Guide |
| NVIDIA NIM | NIM Overview | NIM / NIM Certified Offerings | NIM LLM 3.0 Release Notes | Model-Free NIM | Air-Gap Deployment |
| Triton | Triton User Guide | Backends | OpenAI-Compatible Frontend | Compatibility Matrix |
| NVIDIA Dynamo | Dynamo v1.4.0 | Dynamo v1.0.0 GA | KV-Aware Routing | KV Cache Offloading |
| NVIDIA Metropolis / VSS | NVIDIA Metropolis | DeepStream 9.1 Release Notes | VSS Documentation | Long Video Summarization |
NVIDIA AI Enterpriseの製品ページはこちら ▶
NVIDIA NIMの製品ページはこちら ▶
筆者プロフィール
小宮 敏博(こみや としひろ)
リョーサン菱洋株式会社|ソリューション事業本部 ソリューション技術部 営業技術G 経歴:KDDIで約8年システムエンジニアを経験後、ストレージベンダー・ソフトウェアベンダー・サーバーベンダーにてプリセールス、仮想化ソリューション、HCIビジネスの事業開発に従事。2022年から株式会社トゥモロー・ネットにてセールスエンジニアリング部門長およびソリューション/AIビジネス開発に従事。主にNVIDIA 商材を取り扱っていた。
2025年からは現職。菱洋での実績は・・・NVIDIA AI EnterpriseとNVIDIA DGX Spark™をやっています! 専門分野:仮想化(VMware/Nutanix)関連、NVIDIA AI Enterprise/DGX Spark/LLM推論/AIインフラ(Cuda / Docker / Kubernetes / その他)など
現場目線で、GPU×生成AIの実務ノウハウをわかりやすく発信します。
#NVIDIA #nvidiaaienterprise #LLM推論 #dgxspark #GPU #aiblog
最終更新日: